벤치마크 평가
성능 평가 장에서 본 외재적 지표(벤치마크)로 사후 훈련 모델을 직접 평가합니다. 이들 벤치마크는 대부분 사후 훈련까지 마친(instruct) 모델의 능력을 잽니다. 사전 훈련만 거친 base 모델은 지시를 따르지 않고 텍스트를 이어 쓰기만 하므로, 지시 이행을 전제하는 이 과제들로는 공정하게 잴 수 없습니다. 그래서 평가는 대화 템플릿을 적용한 사후 훈련 모델을 대상으로 합니다.
1AI 인텔리전스 인덱스가 주목하는 벤치마크
Artificial Analysis의 AI Intelligence Index는 단일 벤치마크가 아닌 9개 평가를 가중 평균한 종합 지수입니다. 사후 훈련의 효과를 가늠할 때도 같은 잣대가 쓰이므로, 각 과제가 무엇을, 어떤 형식으로, 왜 재는지 알아두면 결과를 올바르게 해석할 수 있습니다. 최신 정의와 그래프는 Intelligence Index 및 Methodology에서 확인할 수 있습니다.
AI 인텔리전스 인덱스는 9개 평가를 가중 평균해 단일 지수로 산출합니다.
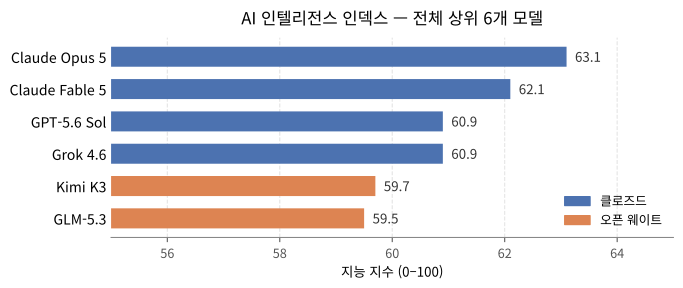
Figure 1:AI 인텔리전스 인덱스 — 모델별 지능 지수 (2026년 8월 21일 기준, 상위 6개 모델, 출처: https://
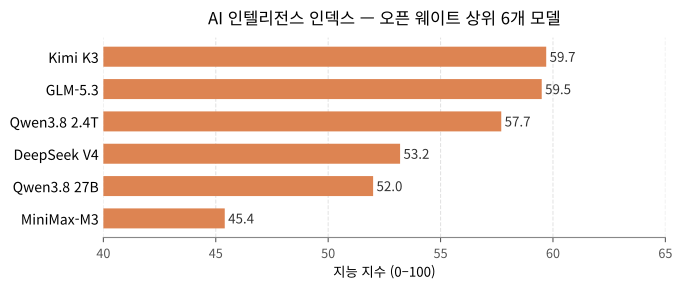
Figure 2:AI 인텔리전스 인덱스 — 오픈 웨이트 모델별 지능 지수 (2026년 8월 21일 기준, 상위 6개 오픈 웨이트 모델, 출처: https://
1.1GDPval-AA v2 — 실무형 업무
다운로드: Artificial Analysis — GDPval-AA v2
다양한 직군의 실제 업무 과제를 에이전트가 수행하는 능력을 잽니다. 인간 기준점 1,000을 Elo 1,500 체계로 변환해 채점하며, 단순 지식 암기를 넘어 장시간·다단계 업무 처리를 평가합니다.
1.2τ³-Banking — 에이전트 도구 활용
다운로드: Artificial Analysis — τ³-Banking
은행 업무 시나리오에서 도구를 호출해 계좌·거래를 처리하는 에이전트 도구 활용 능력을 잽니다. API 호출 정확도와 작업 완료율이 핵심 지표입니다.
1.3Terminal-Bench v2.1 — 터미널 코딩
다운로드: GitHub — laude-institute/terminal-bench
터미널 환경에서 코드를 작성·실행·디버깅하는 에이전트 코딩 능력을 잽니다. 실제 셸 명령과 테스트 통과 여부로 채점합니다.
1.4SciCode — 과학 코딩
다운로드: GitHub — SciCode24/scicode
과학 논문 수준의 전문 코딩과 수치 해석 능력을 잽니다. 물리·화학·생물 분야의 연구 코드를 재현하는 과제로 구성됩니다.
1.5Humanity’s Last Exam — 최전방 추론
다운로드: Hugging Face — cais/hle
수학·과학·인문학 전반에 걸친 최전방 추론과 지식을 잽니다. 전문가가 만든 고난도 4지선다로, 현존 모델도 10%대 초반에 머무르는 가장 어려운 종합 벤치마크 중 하나입니다.
1.6GPQA Diamond — 전문가급 과학
다운로드: GitHub — Idavidrein/gpqa
448개 대학원 수준 과학 문제 중 검증이 가장 엄격한 GPQA-Diamond 198문항으로 전문가 추론을 잽니다. 웹 검색으로도 풀기 어렵게 설계되어 4지선다 정답률로 채점합니다.
1.7CritPt — 물리 추론
다운로드: Artificial Analysis — CritPt
대학 물리 수준의 물리적 추론과 계산 능력을 잽니다. 수식 유도와 수치 풀이의 정확도를 함께 평가합니다.
1.8AA-Omniscience — 지식과 환각
다운로드: Artificial Analysis — AA-Omniscience
다분야 지식의 정확도와 환각률을 동시에 잽니다.
맞추면 가점, 틀리면 감점, 모르면 0점으로 처리해 -100~100 범위의 Omniscience Index로 채점하며, 단순 정답률을 넘어 신뢰성을 측정합니다.
1.9AA-LCR — 장문 추론
다운로드: Artificial Analysis — AA-LCR
장문 컨텍스트에서 정보를 찾고 연결하는 장문 추론 능력을 잽니다. 수만 토큰 문서에서 분산된 단서를 모아 답을 도출해야 합니다.
2벤치마크를 읽을 때 유의점
숫자만으로 모델을 줄 세우기 전에 세 가지를 함께 봐야 합니다.
포화와 변별력: 쉬운 과제는 상위권이 모두 높은 점수라 우열을 가리지 못합니다. AI 인텔리전스 인덱스도 단일 벤치마크가 아닌 9개 과제의 가중 평균으로 평가의 중심을 옮겨 변별력을 확보합니다.
과제별 강자: GDPval은 실무, Terminal-Bench는 코딩, GPQA·HLE는 과학처럼 과제 성격에 따라 강자가 갈립니다. 단일 점수로 '어느 모델이 더 낫다’고 단정할 수 없고, 쓰려는 과제에 맞춰 골라야 합니다.
표본과 분산: HLE·GPQA-Diamond 등은 문항 수가 적어 한두 문제 차이로도 수 %p가 흔들립니다. 신뢰할 만한 추이를 보려면 여러 벤치마크를 함께 봐야 하며, 소표본의 절대 수치는 경향의 참고로만 봐야 합니다.
정리하면 벤치마크는 사후 훈련의 효과를 과제별로 비추는 거울이며, AI 인텔리전스 인덱스가 9개 과제를 종합해 추이를 공개하는 이유도 여기에 있습니다. 규모와 손실(perplexity)의 매끄러운 거듭제곱 관계는 더 큰 표본으로 규모의 법칙 장에서 다룹니다.